1. はじめに
こんにちは、グリーホールディングス株式会社に2025年に新卒入社した高田倫太朗です。
広告配信プラットフォームでは、SDKが組み込まれたアプリから「広告のロードを開始した」「表示された」「クリックされた」といったイベントが大量に送られてきます。これらを受け取ってBigQueryまで運び、レポートや障害調査に使えるようにするのがイベント計測基盤です。
この基盤はもともとAWS上で動いていましたが、分析基盤がBigQueryにあるという事情から、今回GCPへ移行しました。単なるリフト&シフトではなく、収集から取り込みまでのパイプライン全体を組み直す形になっています。
この記事では、移行前に何が課題だったか、それに対してどういう構成を選んだか、そして移行によって何が良くなったかを書きます。
2. 移行前の構成と課題
移行前はこうなっていました。
- 受信 : EC2上のOpenResty(nginxにLuaの実行環境を組み込んだディストリビューション)がリクエストを受け、イベント種別ごとのアクセスログにLTSV形式で書き出す
- 転送 : 同じEC2上のFluentdがそのログをtailし、時間単位のディレクトリに分けてS3へ転送する
- 取り込み : AWS Batch上でDigdagワークフローを起動し、Embulkで 日次 でS3からBigQueryへロードする。ロード先は日単位パーティションのテーブル
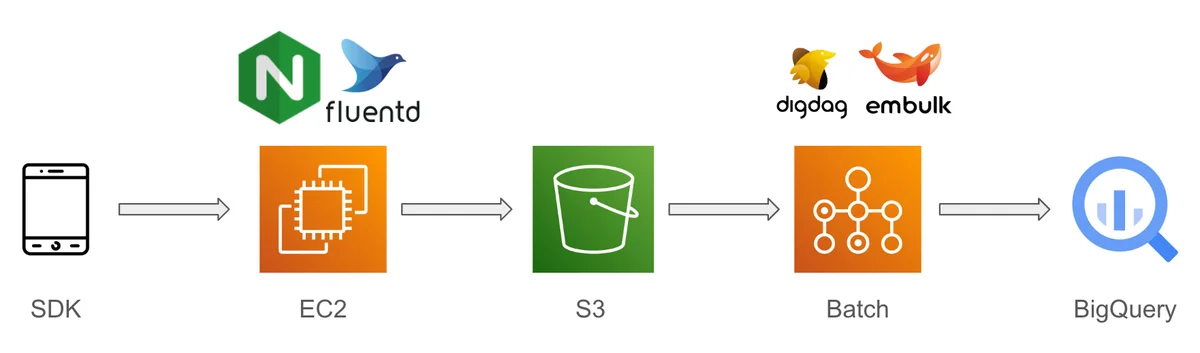
ここには3つの課題がありました。
1. クラウドをまたぐデータ転送のコスト
分析基盤がBigQueryなので、S3に貯めたデータは最終的にAWSからGCPへ送ることになります。イベントの量がそのまま転送量になるため、このコストが継続的に発生し続けていました。加えてイベントサーバー自体もEC2で常時稼働しており、運用費がかかっていました。
2. BigQueryへの反映が日次
取り込みが日次バッチだったため、イベントが発生してからBigQueryで見えるまで 最大で1.5日 かかっていました。障害調査で直近のイベントを確認したくても、当日ぶんはまだ入っていません。
3. バッチとサーバー、両方の運用負荷
取り込み側は、AWS Batchのジョブ定義・Digdagのワークフロー・Embulkの設定という3層を、イベント種別ごとに維持する必要がありました。イベントを1種類増やすだけでも触る場所が多く、ジョブ定義も増え続けます。受信側もEC2上のミドルウェアをAnsibleで構成管理しており、 「イベントを受ける仕組み」と「取り込む仕組み」の両方に、自前で運用するソフトウェアが載っていました 。
3. 移行後の全体像
移行後は次の形になりました。
- 受信 : GKE上のGoサーバーがリクエストを受け、イベント種別ごとにJSONLでローカルの永続ボリュームへ追記する
- 転送 : 同じPod内のFluentdサイドカーがそれをtailし、時間単位のディレクトリに振り分けてgzipでCloud Storageへ転送する
- 取り込み : BigQueryの 外部テーブル でGCS上のファイルを直接参照し、 Scheduled Query が毎時それを変換して本テーブルへ書き込む
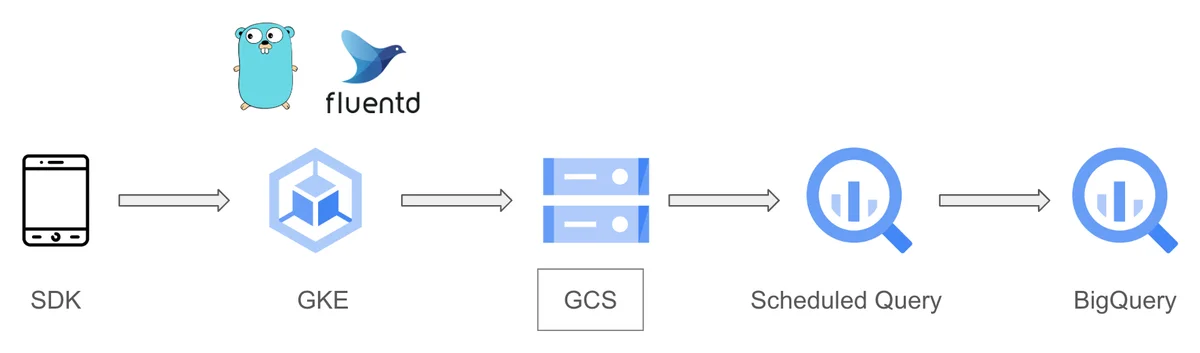
大きな違いは2つです。1つは すべてがGCP内で完結する こと。もう1つは、 定期処理が自前運用からマネージド機能に置き換わった ことです。移行後も「毎時まとめて取り込む」という定期処理そのものは残っていますが、AWS Batch・Digdag・Embulkという3つのミドルウェアを維持する形から、BigQueryのScheduled Queryを登録するだけの形になりました。
4. 構成の選定
主要な選択について、検討したことを書きます。
4-1. コンピューティング基盤: GKE
運用負荷を下げるためマネージドサービスに絞り、Cloud RunとGKEを比較しました。
| Cloud Run | GKE | |
|---|---|---|
| スケール設定 | 細かい制御が難しい | 柔軟に設定可能 |
| 最大同時接続数 | 1インスタンスあたり1,000 | 制限なし |
| 管理コスト | 低い | 中程度 |
決め手は、 Fluentdサイドカーと永続ボリュームを共有する構成を素直に組めること でした。イベントを受けるコンテナとログを転送するコンテナを同居させ、その間をボリュームで繋ぐという形が前提だったため、コンテナ構成とボリュームを自由に定義できることが要件になります。
同時接続数についても、Cloud Runは1インスタンスあたりの上限があります。広告配信のトラフィックは時間帯で数倍変動するので、ピーク時のスケール挙動を細かく制御したいという点でもGKEが有利でした。
4-2. ログの転送経路: Cloud Storage
GCPへログを集める経路として、Cloud Logging・Pub/Sub・Cloud Storageの3つを比較しました。
| Cloud Logging | Pub/Sub | Cloud Storage | |
|---|---|---|---|
| コスト | $0.50/GiB(取り込み量) | $0.039/GiB(流量) | $0.020/GiB/月(保管量) |
| BigQueryへの反映 | ストリーミング | ストリーミング | バッチ(定期ロード) |
| 遅延 | リアルタイム | リアルタイム | 最大1時間程度 |
ここで注意したいのは、 3つの課金単位が揃っていない ことです。Cloud LoggingとPub/Subは通過したデータ量に対する一度きりの課金ですが、Cloud Storageは置いている量に対する月額課金です。単純に数字を並べるとCloud Storageが極端に安く見えますが、保管し続ければ毎月かかります。
今回はライフサイクルルールで30日で削除する運用にしているため、常に1か月ぶんしか保持しません。この前提のもとでは、Cloud Storageが最も安くなります。また今回の要件では「1時間以内に反映されれば十分」で、秒単位のリアルタイム性は求められていません。 リアルタイム性を要件に含めなかったことで、最も安い経路を選べた という形です。
(金額はいずれも検討時点の概算です。Cloud Storageの単価はリージョンによって異なります)
4-3. 実装方式: Goサーバー
「ログを受けてファイルに落とす」だけなら、移行前と同じくnginxのアクセスログに書き出す方法もあります。実際に一度検証もしました。
| nginx + fluentd | Goサーバー + fluentd | |
|---|---|---|
| ログの書き出し | nginxのアクセスログ | アプリケーションのコード |
| ローテーション | logrotate等の外部の仕組み | アプリケーションに内包 |
| ミドルウェアの構成管理 | 必要 | 不要 |
決め手は ログのローテーションをアプリケーション側に持たせられる ことでした。
Fluentdはファイルをtailして転送するので、ローテーションの挙動とtailの追従は密に関係します。圧縮するとローテーション後のファイルが読めなくなる、転送が遅れているときに古いファイルが消えると取りこぼす、といった具合です。nginx構成だとこの調整をnginxの設定とlogrotateの設定に分けて持つことになりますが、Goで書けばローテーションのライブラリを組み込んで、サイズ・世代数・圧縮の有無をコードの中で一箇所に書けます。
課題3で挙げた「受信側のミドルウェア構成管理」も、アプリケーションのコンテナイメージに寄せることで不要になります。
4-4. テーブル設計: 時間パーティションの新規テーブル
毎時のロードに合わせて、BigQuery側も作り直しました。
| 既存テーブル | 新規テーブル | |
|---|---|---|
| パーティション | 日単位 | 時間単位 |
| クラスタリング | なし | 広告枠IDで設定 |
| クエリ効率 | 低い | 高い |
| 移行コスト | 低い | 中程度 |
毎時ロードするのに日単位パーティションのままだと、1日24回同じパーティションを書き換えることになります。時間単位パーティションにして、さらにapp_id(広告枠ID)などでクラスタリングを設定しました。
新規テーブルにすると、既存のクエリは参照先を切り替える必要があります。ただし過去データも新規テーブルへ転送したので、切り替え後は新しいテーブルだけを参照すれば済みます。
5. 実装
ここからは、受信・蓄積・取り込みの3つをどう作ったかを順に書きます。
5-1. イベントサーバー
サーバー側の責務は「リクエストを受けて、受信時刻を足して、JSONLに1行書く」だけです。バリデーションも集計もしません。GoとFiberで書いていますが、ハンドラの本体は30行ほどに収まっています。
設計として意識したのは2点です。
リクエストボディを構造体にマッピングしない
受け取ったJSONをmap[string]anyで受け、サーバー受信時刻だけを足してそのまま書き戻します。
var record map[string]any
if err := json.Unmarshal(c.Body(), &record); err != nil { /* ... */ }

// Append the time field with the server receive time.
record["time"] = time.Now().Unix()
構造体に落とすと、SDK側でフィールドが増えるたびにサーバーの改修とデプロイが必要になります。素通しにしておけば、サーバーはデータの中身の意味を知らずに済みます。フィールドの解釈は、後述するようにすべてBigQuery側のSQLでやります。
何があっても200を返す
不正なイベント種別でも、JSONのパースに失敗しても、書き込みに失敗しても200を返しています。
理由は、 不正なリクエストに対してSDKの再送処理を走らせたくない ことです。クライアントは各アプリに組み込まれたSDKで、エラーを返すとSDKは「送信に失敗した」と判断して再送します。しかし壊れたJSONや存在しないイベント種別は、何度送り直しても成功しません。サーバーが200を返さない限り再送が続くだけなので、受け取った時点で打ち切る形にしました。
エラーを握りつぶしているわけではなく、内容はCloud Loggingへ送ってError Reporting経由で通知されるようにしています。クライアントへのレスポンスと、運用者への通知経路を分けた形です。
GKE上の構成としては、FluentdをサイドカーとしてPod内に同居させ、永続ボリュームを共有しています。Fluentdは「どのファイルをどこまで読んだか」という状態と未送信のバッファをファイルで持つため、Podが入れ替わってもそれらが失われないよう、Deploymentではなく StatefulSet を使ってPodと永続ボリュームを1対1で固定しています。
5-2. Cloud Storageへの蓄積
Fluentdはログをtailし、1時間単位のチャンクに振り分けてGCSへ送ります。
<filter events.**>
  @type record_transformer
  renew_time_key time
</filter>

<match events.**>
  @type gcs
  bucket "#{ENV['GCS_BUCKET_NAME']}"
  path events/${tag[1]}/dt=%Y%m%d/h=%H/${tag[1]}
  store_as gzip

  <buffer tag,time>
    @type file
    path /fluentd/state/gcs
    chunk_limit_size 64m
    timekey 3600
    timekey_zone +0900
    timekey_wait 30
    flush_at_shutdown true
  </buffer>
</match>
renew_time_key timeは、5-1でサーバーが足したtimeフィールドをFluentdのイベント時刻として採用するという指定です。そしてその時刻がdt=%Y%m%d/h=%Hのパス生成に使われます。つまり サーバーが足した受信時刻が、そのままGCS上のディレクトリ構造を決めています 。
このパスをHiveパーティション形式にしたのが移行時の工夫で、BigQuery側から外部テーブルとしてそのまま参照できます。ディレクトリ名のdt/hが、そのまま外部テーブルの列として絞り込みに使えるようになります。
ここで誤解しやすいのですが、timekey 3600は レコードをどの時間スロットのチャンクに入れるかを決めているだけ で、1時間ぶんを貯めてから送るという意味ではありません。チャンクはchunk_limit_size 64mに達した時点で転送されるので、イベント量の多い時間帯は1時間の途中で何度もGCSへ書き出されます。逆にイベントの少ないトピックは容量に達しないため、スロットが閉じてから(timekey_wait 30の猶予のあと)まとめて送られます。
つまり転送のタイミングはイベント量に左右され、 ある時間スロットのデータが出揃うのは、そのスロットが閉じた直後 ということになります。この性質が、次に書くScheduled Queryの処理対象の決め方に効いてきます。
バケットにはライフサイクルルールを設定して30日で削除しています。BigQueryに取り込んだ後の生ログは再取り込み用の保険なので、無期限に置いておく必要はありません。
5-3. BigQueryへの取り込み
取り込みは、移行で一番変わった部分です。自前のバッチ基盤をやめ、 BigQueryの外部テーブルとScheduled Queryだけ で取り込みを組みました。
外部テーブルでGCSを直接参照する
まず、GCS上のファイルをそのまま参照する外部テーブルを作ります。
CREATE OR REPLACE EXTERNAL TABLE `{DATASET}.event_{EVENT_NAME}_external`
(
  raw_data JSON
)
WITH PARTITION COLUMNS (
  dt STRING,
  h  STRING
)
OPTIONS (
  format = 'CSV',
  field_delimiter = '\x01',
  quote = '',
  uris = ['gs://{BUCKET_NAME}/events/{EVENT_NAME}/*'],
  hive_partition_uri_prefix = 'gs://{BUCKET_NAME}/events/{EVENT_NAME}/',
  require_hive_partition_filter = true
); JSONLを読むのにformat = 'CSV'という一見ちぐはぐな指定をしています。SDKから送られてくるデータには、同じJSONパスの値が行によってオブジェクトだったり文字列だったりする揺れがあります。これをNEWLINE_DELIMITED_JSON形式で読もうとしたところ、 その行だけでなくファイル全体の読み込みが失敗する という挙動に当たりました。
そこで区切り文字の現れない1カラムのCSVとして1行をまるごと読み込み、そのテキストをJSON型の列として解釈させています。こうするとパースの失敗が行単位に閉じ込められ、ファイル全体が読めなくなることがなくなります。
require_hive_partition_filter = trueを付けているのも重要で、これによりクエリは必ずdt/hでの絞り込みを伴うようになり、全期間をスキャンする事故を防げます。
Scheduled Queryで毎時変換する
取り込み本体はScheduled Queryです。毎時実行し、 2時間前の1時間分 を処理します。
BEGIN
  DECLARE target_partition TIMESTAMP
    DEFAULT TIMESTAMP_TRUNC(TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 2 HOUR), HOUR);
  DECLARE target_dt STRING
    DEFAULT FORMAT_TIMESTAMP('%Y%m%d', target_partition, 'Asia/Tokyo');
  DECLARE target_h STRING
    DEFAULT FORMAT_TIMESTAMP('%H', target_partition, 'Asia/Tokyo');

  DELETE FROM `{DATASET}.event_{EVENT_NAME}`
  WHERE _PARTITIONTIME = target_partition;

  INSERT INTO `{DATASET}.event_{EVENT_NAME}` (...)
  SELECT
    target_partition,
    SAFE_CAST(JSON_VALUE(raw_data, '$.time') AS INT64) AS time,
    COALESCE(
      SAFE_CAST(JSON_VALUE(raw_data, '$.sdktime') AS INT64),
      SAFE_CAST(JSON_VALUE(raw_data, '$.sdk_time') AS INT64)
    ) AS sdk_time,
    COALESCE(JSON_VALUE(raw_data, '$.sessionid'), JSON_VALUE(raw_data, '$.session_id')) AS session_id,
    ...
  FROM `{DATASET}.event_{EVENT_NAME}_external`
  WHERE dt = target_dt AND h = target_h;
END;
設計で意識したのは次の3点です。
2時間前を処理する
5-2で書いたとおり、ある時間スロットのデータがGCSに出揃うのは、そのスロットが閉じた直後です。14時台のデータであれば、最後のチャンクが届くのは15時を過ぎてからになります。
そのため直前の1時間を処理しようとすると、まだ到着していないデータを取りこぼします。2時間前を対象にすることで、ファイルが確実に出揃った状態で処理できます。
DELETEしてからINSERTする
対象パーティションをDELETEしてINSERTしているので、同じ時間を何度流しても重複しません。この冪等性のおかげで、欠損が見つかったときは 同じSQLの基準時刻を差し替えて流し直すだけ で復旧できます。再取り込み専用のスクリプトを別に持つ必要がなく、変換ロジックが二重管理になりません。
型の揺れの吸収はSQLでやる
sdktimeとsdk_time、sessionidとsession_idのように、SDKのバージョンによってキー名や型が揺れているフィールドがあります。これをCOALESCEとSAFE_CASTで吸収しています。
この処理はサーバー側でやることもできますが、SQLに置くほうが都合が良いと判断しました。 サーバーに入れると、変換ロジックを変えるたびにデプロイが必要で、しかも過去のデータには遡って適用できません 。SQL側に置けば、変換を直して流し直すだけで過去分もまとめて直ります。生ログをそのままGCSに残しているからこそ取れる選択です。
なお、Scheduled Queryのスケジュールはevery 1 hoursのように指定します。毎時実行では分を指定する書き方がないため、開始時刻の分を:10に設定して「毎時10分実行」にしています。
6. 移行によって得られたもの
| 移行前 | 移行後 | |
|---|---|---|
| BigQueryへの反映 | 日次(最大1.5日) | 毎時(最大約2時間) |
| データ転送 | AWS → GCP をまたぐ | GCP内で完結 |
| ログの保管 | S3 | Cloud Storage(30日で削除) |
| 定期処理の運用 | AWS Batch + Digdag + Embulk | BigQuery Scheduled Query |
| サーバーの構成管理 | EC2 + Ansible | GKE + コンテナイメージ |
| テーブル | 日パーティション | 時間パーティション + クラスタリング |
6-1. 準リアルタイム性の向上
最大1.5日だった反映遅延が、最大でも約2時間になりました。 これが一番実感のある変化です。障害調査で「さっきのイベントがどうなっているか」を見たいとき、以前は翌日以降まで待つしかありませんでしたが、いまは2時間待てばSQLで追えます。
秒単位のリアルタイムではありませんが、要件に照らせば十分で、その代わりに最も安い経路を選べています。 どこまでのリアルタイム性が本当に必要かを最初に決めたことが、そのままコスト構造の選択になった 、というのがこの移行で一番学びになった部分でした。
6-2. コストの削減
イベント収集にかかるインフラ費用を、約60%削減できました。
削減の内訳は大きく2つです。1つはデータ転送費で、S3からBigQueryへクラウドをまたいで送っていた分がGCP内で完結するようになり、まるごとなくなりました。もう1つはサーバーの費用で、EC2で常時稼働させていた固定費から、GKE上でトラフィックに応じてスケールする形に変わりました。深夜帯にリクエストが減れば台数も減るので、ピークに合わせた台数を24時間維持する必要がなくなっています。
6-3. 運用コストの削減
これは金額よりも、 自前で維持するソフトウェアが減ったこと が大きいです。
課題3で書いたとおり、移行前は受信側でEC2のミドルウェア構成をAnsibleで管理し、取り込み側でAWS Batch・Digdag・Embulkの3層をイベント種別ごとに維持していました。
移行後は、受信側はコンテナイメージとマニフェストだけになり、取り込み側はSQLのテンプレート1つとScheduled Queryの登録だけになりました。イベント種別が増えても、テンプレートに種別名を流し込んでテーブルとScheduled Queryを作るだけで済みます。定期処理そのものはなくなっていませんが、 それを動かすための基盤を自分たちで持たなくなりました 。
6-4. クエリ効率の改善
時間パーティション化と広告枠IDでのクラスタリングによって、「特定の広告枠の直近数時間」といった調査向けのクエリでスキャン量が大きく減りました。日パーティションだと1日ぶんをスキャンしていた問い合わせが、必要な時間だけで済みます。
7. まとめ
AWS上の「nginx + S3 + 日次バッチ」構成を、GCP上の「Go + Cloud Storage + BigQuery Scheduled Query」構成へ移行しました。
振り返ると、うまくいった判断は それぞれのレイヤーに何を持たせるかを最初に決めたこと だったと思います。
- サーバーは受信とログの書き出しだけを持ち、データの意味を知らない
- Cloud Storageは生ログをそのまま持ち、いつでも読み直せる状態にしておく
- 解釈と変換はすべてBigQuery側のSQLに置き、流し直せるようにする
この切り分けによって、変換ロジックを直したくなったときにサーバーのデプロイが不要になり、欠損が出たときも同じSQLを流し直すだけで復旧できるようになりました。
一方で課題も残っています。Fluentdは転送処理でCPUを消費するため、リソース配分の見直しを何度か行っており、より軽量なVector(Rust製のログ転送ツール)への移行を検討しています。また、取り込みの遅延を短くしたい要望が出てきた場合には、timekeyとScheduled Queryの間隔を詰めるか、Pub/Sub経由のストリーミングへ切り替えるかという判断が必要になります。
同じように「大量のイベントを集めて分析基盤に流す」構成を検討している方の参考になれば幸いです。